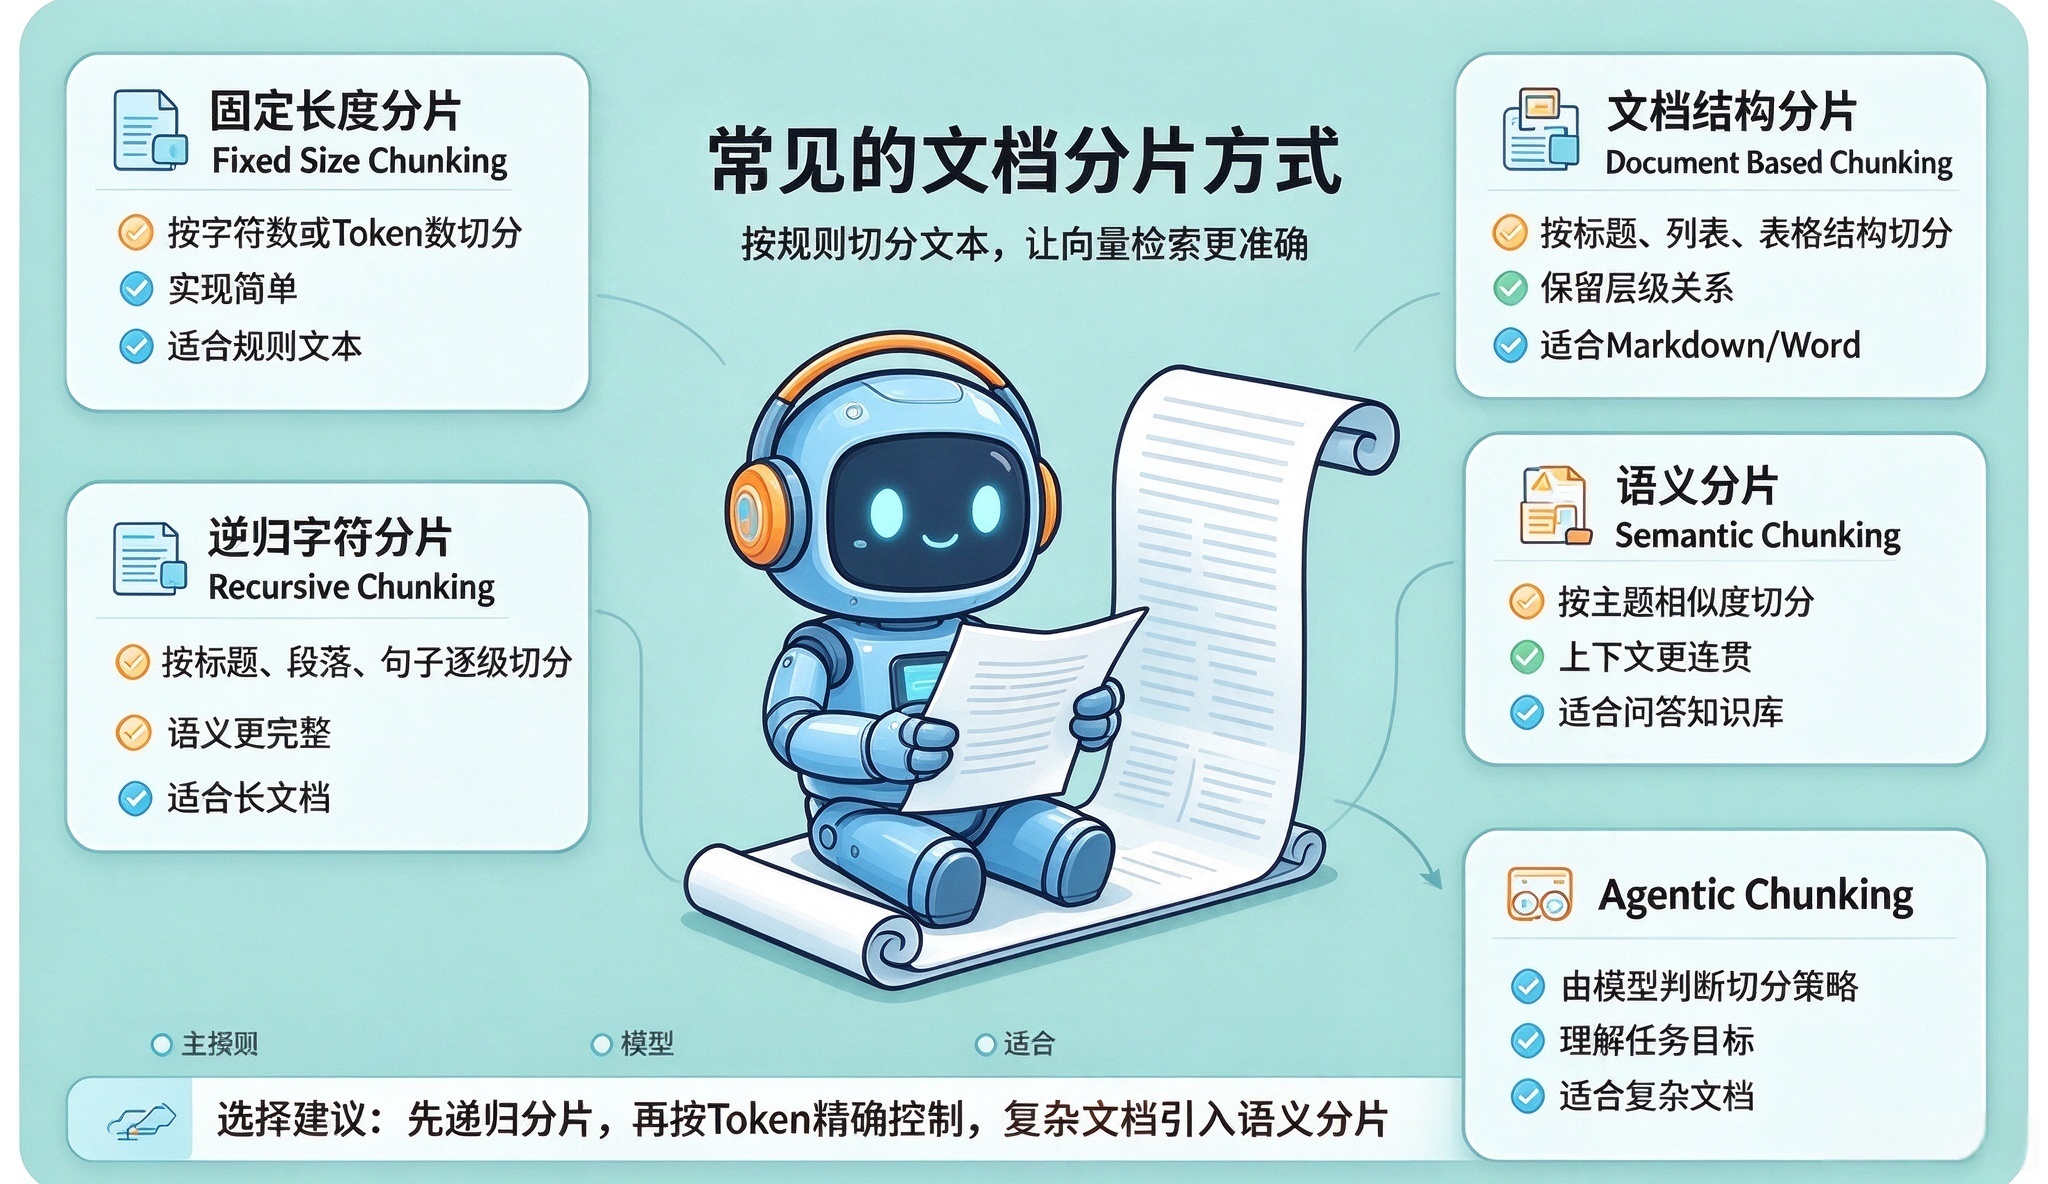
由于大模型上下文窗口的限制,这意味着我们不可能一次性把整篇文档送入模型。而在RAG中,我们需要将文档拆分成很多的小文本块(chunk),到检索生成环节的时候,检索的就是与用户问题最相似的一部分小文本块,从而让RAG这个“知识外挂”的大小在模型上下文可接受的范围内。这个“拆分”的过程就是文档分片。
PS:关于名字,有的叫Chunking,有的也叫Splitting,不管是Chunking还是Splitting,都是一回事儿,不用纠结,中文叫分段、分片、分块,也都行,也不要纠结。
Chunking 是指将大型文档切分成一个个更小的、语义连贯的文本块,以便于检索系统精确地找到相关信息,并送入语言模型进行处理。Chunking 是连接海量原始知识库和有限的 LLM 上下文窗口之间的关键桥梁。它不是一个可有可无的优化选项,而是 RAG 架构能够成立和高效运作的基石。这一步至关重要,因为它确保文本符合嵌入模型的输入大小。
分块的方式有很多种,不同的人或者机构也会试着总结出不同的分块的方法,但是总结下来,比较典型的都是分成以下5个level:
Fixed Size Chunking(固定大小分块)
Recursive Chunking(递归分块)
Document Based chunking(基于文档分块)
Semantic Chunking(语义分块)
LLM-based Chunking(基于LLM分块)
固定大小分块
这是最原始也是最简单的文本分段方法。它将文本分割成指定数量的字符块,而不管其内容或结构是怎么样的。有人把它叫做Character Splitting、也有人叫做Fixed Size Chunking,都是一回事儿。
他主要有两个关键参数:
chunk_size:块中的字符数量
chunk_overlap: 顺序块中重叠的字符数。
overlap,是为了尽量避免将单个上下文片段切割成多个片段。这将导致块之间出现重复数据。
比如,我把一段关于斗破苍穹小说的介绍,设置为chunk_size=20的分段(以下截图来自:https://www.chunkviz.com/ ):
《斗破苍穹》是中国网络作家天蚕土豆创作的玄幻小说,2009年4月14日起在起点中文网连载,2011年7月20日完结,首版由湖北少年儿童出版社出版。2010年7月,该作品部分章节被编为《废材当自强》由湖北少年儿童出版社出版 [22]。
小说以斗气大陆为背景,讲述天才少年萧炎从斗气尽失逐步成长为斗帝的历程,期间通过收集异火、修炼丹药突破困境,最终解开斗帝失踪之谜并前往大千世界 [23]。作品构建了炼药师体系、异火榜及天鼎榜等设定,其中炼药师需具备火木双属性斗气与灵魂感知力 [6]。
该小说全网点击量近100亿次,实体书累计销量超300万册,2017年7月荣登“2017猫片胡润原创文学IP价值榜”榜首 [13-14]。2020年8月被国家图书馆永久典藏并位列中国文化产业IP价值综合榜TOP50前五 [6],其改编动画在腾讯视频创下2.6万热度值纪录,并推出盲盒、游戏等衍生品 [25]。幻维数码制作的动画年番《斗破苍穹》重现佛怒火莲等经典场景,多次入围华语剧集口碑榜前十 [24]。2025年1月入选“2024网络文学神作榜”,同年2月28日荣获2024阅文IP盛典20大荣耀IP [15-16]。2025年11月,上海金山区人民法院宣判国内首例AI著作权侵权案,用户擅自使用《斗破苍穹》角色“美杜莎”形象训练AI模型被判赔偿5万元 [26-29]。
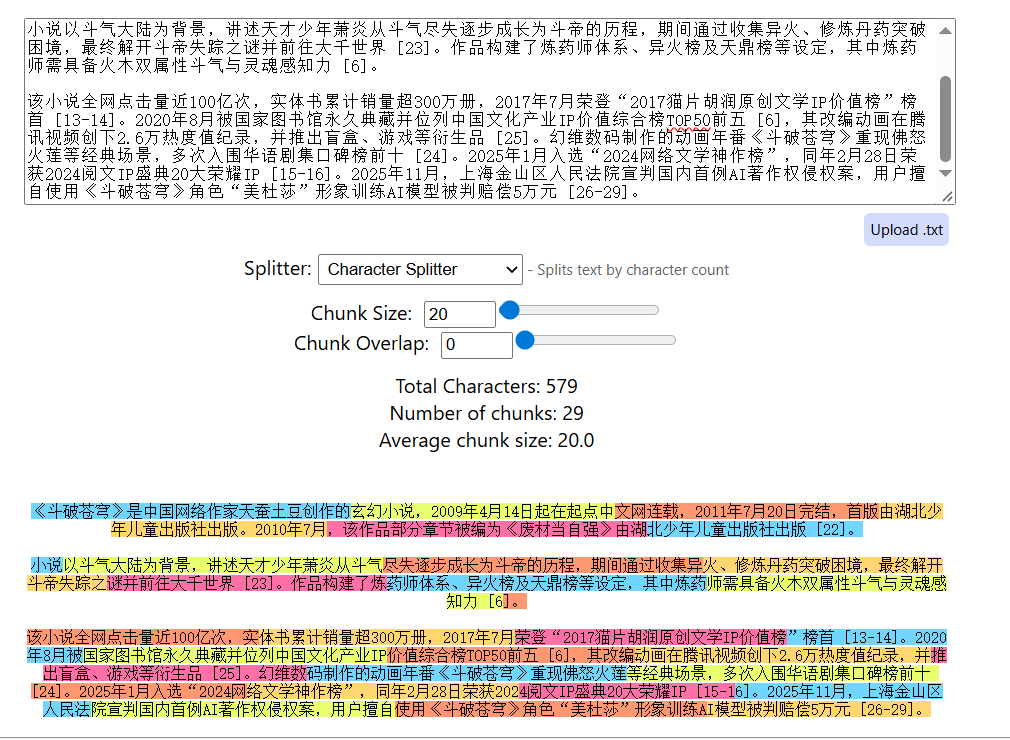
可以看到,每一个分段的字符数都是20,长度都一样。
如果我给他设置个overlap,比如5:
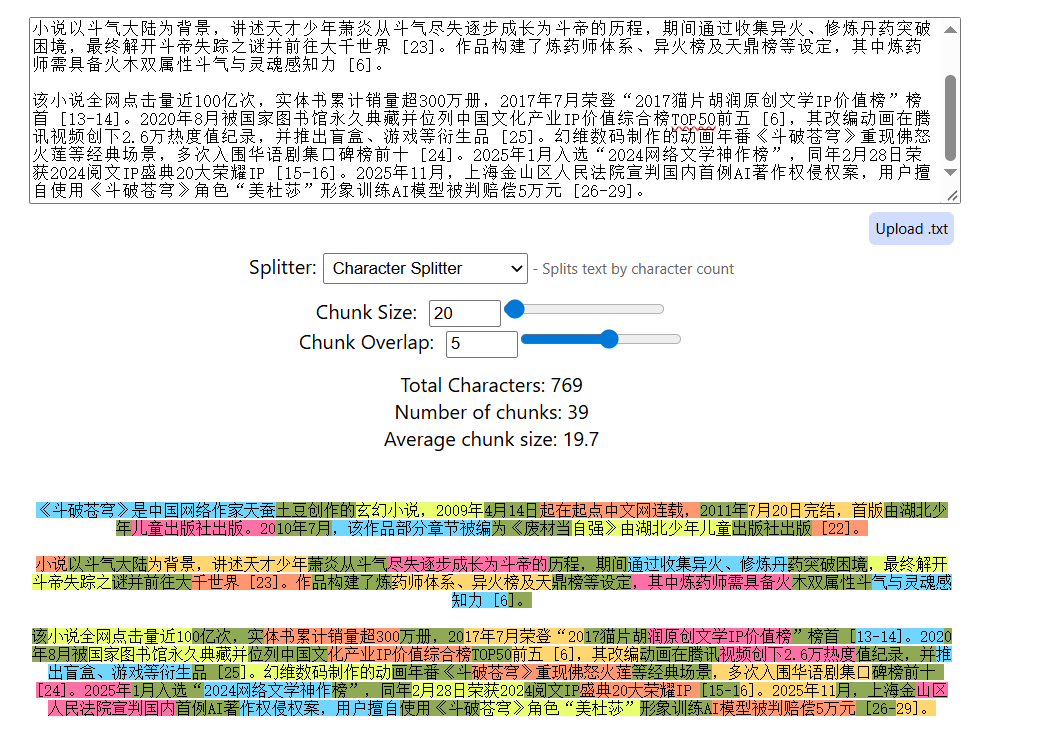
你就会发现,相邻的两个分段中,会有5个字符是重复的。因为直接分段可能导致文本块边界处的语义断裂,而加一个overlap就可以通过重叠部分内容,确保每个块的开头包含前一个块的结尾信息,减少语义断裂。
这个方案的优点就是非常简单,按照固定大小分段就行了,但是缺点也比较明显,那就是完全没考虑文档结构,所谓文档结构就是文档中本身的一些分段、空格、换行等等。就像我们自己读文档一样,遇到换行的时候,就知道一段结束了。
所以,有了另外一种切割方式。
递归分块(常用)
递归分块,他的主要方式就是可以指定一些列分隔符,这些分隔符可以用来分割文档。比如常见的:
"\n\n" - 双换行符,或通常指段落分隔
"\n" - 换行
" " - 空格
"" - 空字符
同样一段文本,我们选择这种切割方式:
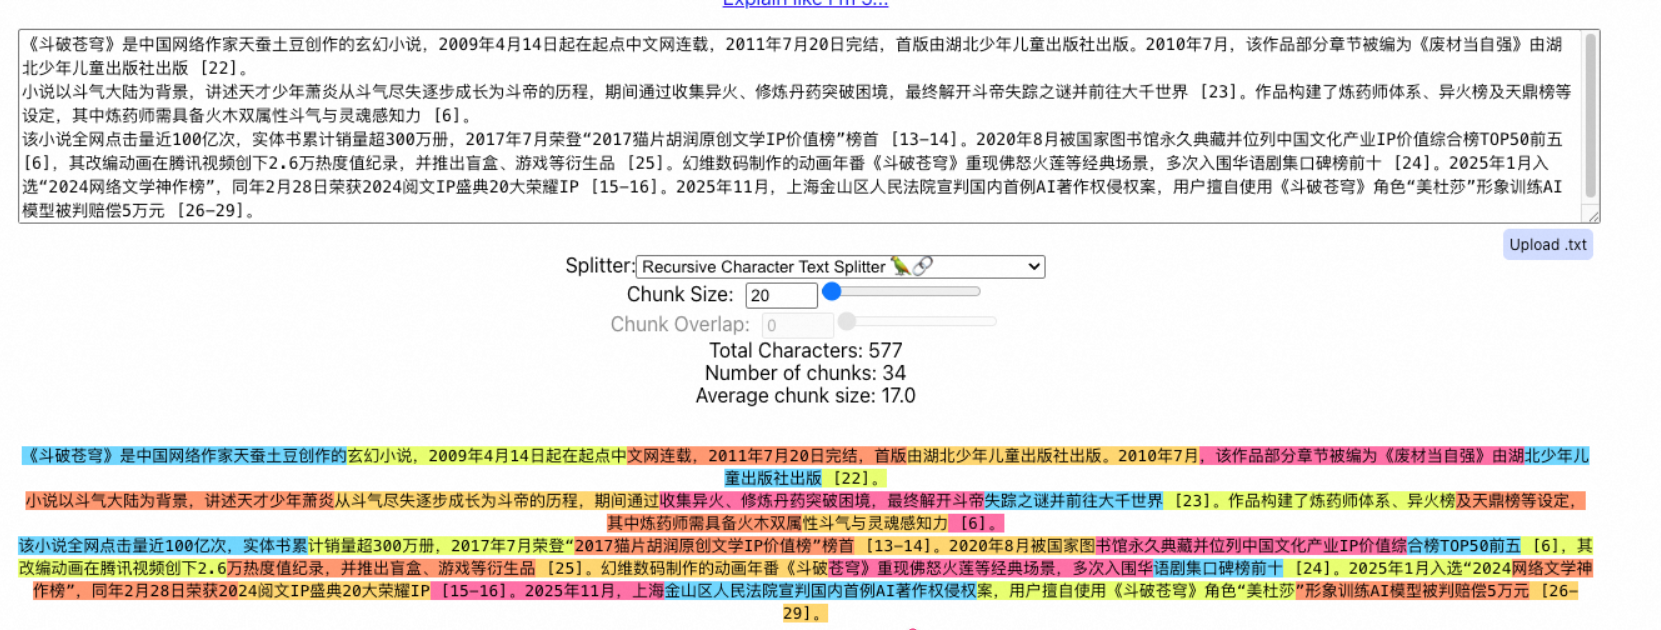
可以看到,这次切割结果和上一次是不一样的,尤其是在分段处,比如第一段结束的[22]。 就是单独切割出来的,而下一次切割时从下一段开始的。
这种切割方式,一般会比上一种切分出来的段会更多一些。
这种分块方式,很多人不知道,他为什么叫递归分块呢?递归体现在哪里呢?其实,大家可以看一下源码,比如com.alibaba.cloud.ai.transformer.splitter.RecursiveCharacterTextSplitter:
public RecursiveCharacterTextSplitter(int chunkSize, String[] separators) {
  if (chunkSize <= 0) {
    throw new IllegalArgumentException("Chunk size must be positive");
  }

  this.chunkSize = chunkSize;
  this.separators = Objects.requireNonNullElse(separators,
      new String[] { "\n\n", "\n", "。", "!", "?", ";", ",", " " });
}

private void splitText(String text, int separatorIndex, List<String> chunks) {
  if (text.isEmpty()) {
    return;
  }

  if (text.length() <= chunkSize) {
    chunks.add(text);
    return;
  }

  if (separatorIndex >= separators.length) {
    // Final fallback - split by chunkSize 最终按块大小分割
    for (int i = 0; i < text.length(); i += chunkSize) {
      int end = Math.min(i + chunkSize, text.length());
      chunks.add(text.substring(i, end));
    }
    return;
  }

  String separator = separators[separatorIndex];
  String[] splits;
  if (separator.isEmpty()) {
    // Split by character
    splits = new String[text.length()];
    for (int i = 0; i < text.length(); i++) {
      splits[i] = String.valueOf(text.charAt(i));
    }
  }
  else {
    // Split by separator
    splits = text.split(separator);
  }

  for (String split : splits) {
    if (split.length() > chunkSize) {
      splitText(split, separatorIndex + 1, chunks);
    }
    else {
      chunks.add(split);
    }
  }
}重点就在下面这个for循环得地方,可以看到就是一个递归调用splitText方法。大致的流程就是从前面的new String[] { "\n\n", "\n", "。", "!", "?", ";", ",", " " } 中逐个取出字符进行切分,然后判断是否符合条件(主要是看长度),如果符合直接返回,如果不符合继续用下一个字符进行分割。
for (String split : splits) {
    if (split.length() > chunkSize) {
       splitText(split, separatorIndex + 1, chunks);
    }
    else {
       chunks.add(split);
    }
}
基于文档分块(常用)
上面这个切割方式已经好了一些,但是还是有进步空间,有些问题还是解决不了,比如说带 Markdown 的文档、他切割的其实就不好。
所以,针对这个问题,可以使用支持根据文档没在结构进行分割的方式,这种方式针对markdown文档、PYTHON/JS文档、带有表格的文档以及带有图片的PDF文档等都会更加的友好。
语义分块(常用)
以上三个分块方式都是只关注文档的内容和结构,并需要保持块大小的恒定值,而忽略了语义。想要更好分块,最好是从文档中提取语义意义,然后评估这些块之间的语义关系,将语义相似的块保持在一起。
这种一般需要借助自然语言处理(NLP)技术,通过理解文本的语义边界(如主题转换、逻辑段落)进行智能分割。
智能分块
上面的这个分段方式是基于NLP的模型分块的,那么还有一种基于大模型分段的方案。
LLM-based Chunking或者叫做Agentic Chunking,反正都是借助大模型来做文档切割。比如我让DeepSeek帮我切割:
以下文档内容,请帮我做chunking:
《斗破苍穹》是中国网络作家天蚕土豆创作的玄幻小说,2009年4月14日起在起点中文网连载,2011年7月20日完结,首版由湖北少年儿童出版社出版。2010年7月,该作品部分章节被编为《废材当自强》由湖北少年儿童出版社出版 [22]。小说以斗气大陆为背景,讲述天才少年萧炎从斗气尽失逐步成长为斗帝的历程,期间通过收集异火、修炼丹药突破困境,最终解开斗帝失踪之谜并前往大千世界 [23]。作品构建了炼药师体系、异火榜及天鼎榜等设定,其中炼药师需具备火木双属性斗气与灵魂感知力 [6]。该小说全网点击量近100亿次,实体书累计销量超300万册,2017年7月荣登“2017猫片胡润原创文学IP价值榜”榜首 [13-14]。2020年8月被国家图书馆永久典藏并位列中国文化产业IP价值综合榜TOP50前五 [6],其改编动画在腾讯视频创下2.6万热度值纪录,并推出盲盒、游戏等衍生品 [25]。幻维数码制作的动画年番《斗破苍穹》重现佛怒火莲等经典场景,多次入围华语剧集口碑榜前十 [24]。2025年1月入选“2024网络文学神作榜”,同年2月28日荣获2024阅文IP盛典20大荣耀IP [15-16]。2025年11月,上海金山区人民法院宣判国内首例AI著作权侵权案,用户擅自使用《斗破苍穹》角色“美杜莎”形象训练AI模型被判赔偿5万元 [26-29]。
以下是他的切割结果:
1  《斗破苍穹》是中国网络作家天蚕土豆创作的玄幻小说,2009年4月14日起在起点中文网连载,2011年7月20日完结,首版由湖北少年儿童出版社出版。2010年7月,该作品部分章节被编为《废材当自强》由湖北少年儿童出版社出版 [22]。
2  小说以斗气大陆为背景,讲述天才少年萧炎从斗气尽失逐步成长为斗帝的历程,期间通过收集异火、修炼丹药突破困境,最终解开斗帝失踪之谜并前往大千世界 [23]。
3  作品构建了炼药师体系、异火榜及天鼎榜等设定,其中炼药师需具备火木双属性斗气与灵魂感知力 [6]。
4  该小说全网点击量近100亿次,实体书累计销量超300万册,2017年7月荣登“2017猫片胡润原创文学IP价值榜”榜首 [13-14]。2020年8月被国家图书馆永久典藏并位列中国文化产业IP价值综合榜TOP50前五 [6]。
5  其改编动画在腾讯视频创下2.6万热度值纪录,并推出盲盒、游戏等衍生品 [25]。幻维数码制作的动画年番《斗破苍穹》重现佛怒火莲等经典场景,多次入围华语剧集口碑榜前十 [24]。
6  2025年1月入选“2024网络文学神作榜”,同年2月28日荣获2024阅文IP盛典20大荣耀IP [15-16]。
7  2025年11月,上海金山区人民法院宣判国内首例AI著作权侵权案,用户擅自使用《斗破苍穹》角色“美杜莎”形象训练AI模型被判赔偿5万元 [26-29]。
常用的分块方式
到底哪些比较常用呢?其实我们可以看一下百炼/Coze/Dify这种平台上支持的,一般都是比较常用的:
百炼
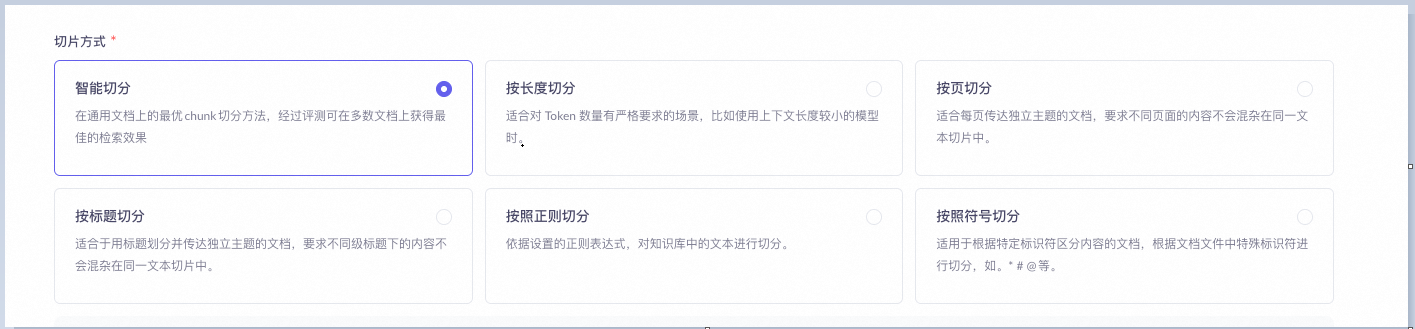
百炼目前支持6种切分方式:
智能切分(递归分块+语义分块?)
按长度切分(固定大小分块)
按符号切分(递归分块)
按页切分(类似递归分块)
按标题切分(类似递归分块)
按正则切分(类似递归分块)
Dify
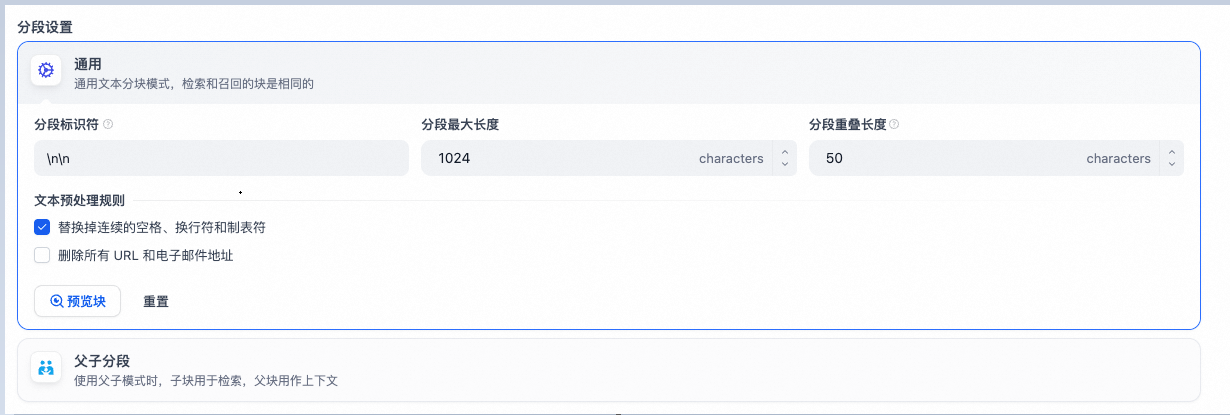
Dify主要支持两种,一种是通用分块,其实也就是递归分块。
Coze
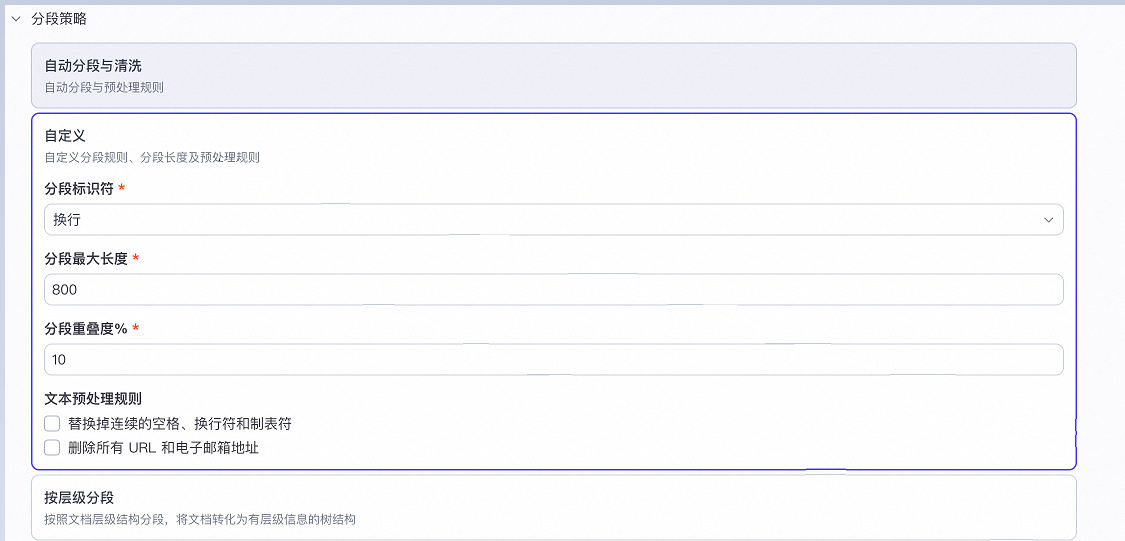
从上面三种常见平台支持的方案来看,其实目前最常用的就是递归分块,包括Dify中的通用分块,Coze中的自定义分块,都是一样的,全部都是递归分块,都支持传入3种核心参数:
分段标识符
分段最大长度
分段重叠度/重叠长度
除了上面这种递归分块比较常用以外,还有一种比较常用的就是语义分块了,他的效果比较好,很多平台上面的智能分块,其实就是依赖语义分块实现的。
关于语义分块的实现,在Spring AI Alibaba 和LangChain4J中都有:
SentenceSplitter:Spring AI中的语义分块
DocumentBySentenceSplitter:LangChain4J中的语义分块
在两个实现的具体实现代码中,都有这么两句:
1  SentenceDetectorME sentenceDetector = new SentenceDetectorME(sentenceModel);

2  String[] texts = sentenceDetector.sentDetect(text);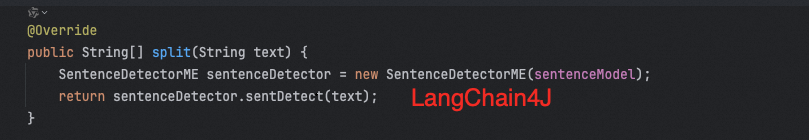
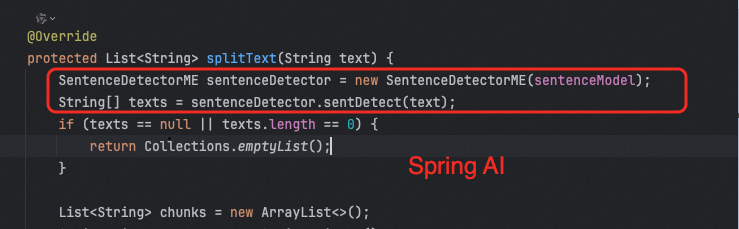
这个SentenceDetectorME是OpenNLP 提供的句子分割器类,ME 表示 "Maximum Entropy"(最大熵模型)。getSentenceModel() 方法用于从资源路径加载预训练的句子模型(/opennlp/opennlp-en-ud-ewt-sentence-1.2-2.5.0.bin 文件)。通过这个自然语言模型来进行文本分块。
文档分片的代码实现
本次主要介绍三种:
1、Spring AI的固定长度分片
2、Spring AI Alibaba的递归分片
3、LangChain4J的语义分片
Spring AI的文档分片
在 Spring AI 的 ETL Pipeline 模块中,TextSplitter 是所有文本拆分器的抽象基类。它定义了统一的接口,任何拆分策略(按句、按段、按 token)都可以通过继承它实现。
但是目前,Spring AI 官方仅提供了一个具体实现类:TokenTextSplitter:按 token 数量 拆分文本。Token 是模型处理文本的最小单位,可能由一个或多个字符组成。
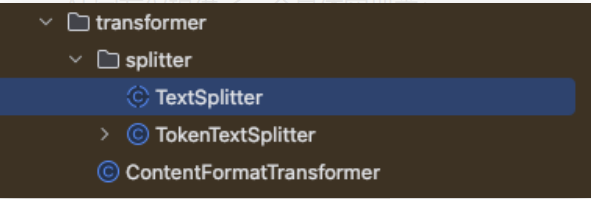
TokenTextSplitter
TokenTextSplitter 会先将文本编码成模型的 token,然后根据设定的每块 token 数,把文本拆成多个长度适合模型上下文的小文本块。
chunkSize:每个文本块的目标大小(以token为单位)(默认值:800)。切分后的每个 Document 对象包含的最大 Token 数量。
minChunkSizeChars:每个文本块的最小字符数(以字符为单位)(默认值:350)。如果拆分出的最后一块字符数少于这个值,它可能会被丢弃或合并,以防止生成过短、没有语义信息的碎片。
minChunkLengthToEmbed:只有长度超过此值的块才会被发送给向量模型。这可以过滤掉无意义的空行或超短片段。
maxNumChunks: 单个文档允许拆分出的最大块数(默认值:10000)。防止因为文档过大导致生成太多分块。
keepSeparator:是否在块中保留分隔符(如换行符)(默认值:true)。
/**
 * 文档分片
 */
public List<Document> split(List<Document> documents) {
    if (CollectionUtils.isEmpty(documents)) {
        return Collections.emptyList();
    }

    TokenTextSplitter splitter = new TokenTextSplitter(
            // 每块最多 600 tokens
            600,
            // 每块至少 400 字符再考虑断点
            300,
            // 太短的不做嵌入
            5,
            // 最多拆分8000块
            8000,
            // 保留句号、换行符
            true
    );

    return splitter.apply(documents);
}
SpringAI文档分片的缺陷
虽然我们已经能够在 Spring AI 中实现文档分片,但 Spring AI 提供的 TokenTextSplitter 功能过于简单了。一些常用的智能体框架,如 LangChain / LangChain4j,在文档分片方面的能力更强、更灵活。
首先,Spring AI 的切分方式不具备重叠(overlap)机制,也就是说相邻文本块之间没有共享内容。相比之下,LangChain / LangChain4j 通常提供 overlap 参数,用于在前一个文本块和下一个文本块之间保留一定数量的字符或 token,这样可以有效避免语义被切断,提高检索和召回的准确性。
在Spring AI的github上,也有一些人早就提出了这个issue优化,只是官方一直没有相关回应,也许在Spring AI 未来的某个版本,也会解决这个问题。
https://github.com/spring-projects/spring-ai/issues/2123?utm_source=chatgpt.com
自定义重叠段落分片器
/**
 * 自定义分片器:支持 chunkSize、overlap,并按段落拆分
 */
public class OverlapParagraphTextSplitter extends TextSplitter {

    // 每块最大字符数
    private final int chunkSize;

    // 相邻块之间重叠字符数
    private final int overlap;

    public OverlapParagraphTextSplitter(int chunkSize, int overlap) {
        if (chunkSize <= 0) {
            throw new IllegalArgumentException("chunkSize 必须大于 0");
        }
        if (overlap < 0) {
            throw new IllegalArgumentException("overlap 不能为负数");
        }
        if (overlap >= chunkSize) {
            throw new IllegalArgumentException("overlap 不能大于等于 chunkSize");
        }
        this.chunkSize = chunkSize;
        this.overlap = overlap;
    }

    public List<String> splitText(String text) {
        if (StringUtils.isBlank(text)) return Collections.emptyList();

        String[] paragraphs = text.split("\\n+");
        List<String> allChunks = new ArrayList<>();
        StringBuilder currentChunk = new StringBuilder();

        for (String paragraph : paragraphs) {
            if (StringUtils.isBlank(paragraph)) continue;

            int start = 0;
            while (start < paragraph.length()) {
                int remainingSpace = chunkSize - currentChunk.length();
                int end = Math.min(start + remainingSpace, paragraph.length());

                if (currentChunk.length() > 0) currentChunk.append("\n");
                currentChunk.append(paragraph, start, end);

                // 如果当前块已满,保存并生成新块
                if (currentChunk.length() >= chunkSize) {
                    allChunks.add(currentChunk.toString());

                    // 计算重叠
                    String overlapText = "";
                    if (overlap > 0) {
                        int overlapStart = Math.max(0, currentChunk.length() - overlap);
                        overlapText = currentChunk.substring(overlapStart);
                    }

                    currentChunk = new StringBuilder();
                    if (!overlapText.isEmpty())
                        currentChunk.append(overlapText);
                }

                start = end;
            }
        }

        if (currentChunk.length() > 0)
            allChunks.add(currentChunk.toString());

        return allChunks;
    }

    /**
     * 批量拆分
     */
    public List<Document> apply(List<Document> documents) {
        if (CollectionUtils.isEmpty(documents)) {
            return Collections.emptyList();
        }

        List<Document> result = new ArrayList<>();
        for (Document doc : documents) {
            List<String> chunks = splitText(doc.getText());
            for (String chunk : chunks) {
                result.add(new Document(chunk));
            }
        }
        return result;
    }
}
@GetMapping("/read")
public List<Document> readDocument(@RequestParam("path") String path) {
File file = new File(path);
if (!file.exists() || !file.isFile()) {
throw new IllegalArgumentException("文件不存在或不是有效文件: " + path);
}
try {
// 1. 加载文档
List<Document> documents = selector.read(file);
// 2. 文本清洗
documents = cleanDocuments(documents);
// 3. 文档分片
// documents = split(documents);
OverlapParagraphTextSplitter splitter = new OverlapParagraphTextSplitter(
// 每块最大字符数
400,
// 块之间重叠 100 字符
100
);
List<Document> apply = splitter.apply(documents);
return apply;
} catch (IOException e) {
throw new RuntimeException("读取文件失败: " + e.getMessage(), e);
}
}